

0
剖析大模型产生幻觉的三大根源
编者按: 为什么大语言模型总是 "一本正经地胡说八道"?它们是在故意欺骗,还是被训练机制 "逼" 成了这样?
我们今天为大家带来的这篇文章指出:幻觉并非模型的故障,而是当前训练与评估机制下的一种理性选择 ------ 当模型因进行猜测获得奖励、因坦白 "我不知道" 而被惩罚时,编造答案就成了最优策略。
文章系统剖析了幻觉的三大根源:预训练阶段以统计预测替代事实判断、后训练阶段(如 RLHF)采用非黑即白的二元评分机制、以及评估基准测试普遍忽视 "弃答" 行为的合理性。作者还提出了一套基于置信度阈值的新型评分机制 ------ 通过设定惩罚规则,使 "不确定时选择不说" 在数学上成为最优解。
作者 | Florian
编译 | 岳扬
多年来,人们一直在追问:为什么大语言模型(LLMs)会产生幻觉?本文将探讨 OpenAI 的最新研究是如何解答这一问题的。
语言模型有个奇怪的习惯:即便对自己谈论的内容一无所知,它们也会自信满满地编造内容。这类不正确却听起来合理的回答,通常被称为 "幻觉"。 尽管现在的模型已有比较大的进步,但这一问题仍未根除。不过,有一点值得一提,这与人类在现实世界中经历的幻觉截然不同。
来看一个简单的例子。当向开源模型 DeepSeek-V3(600B 参数,2025 年 5 月 11 日)提问:
Adam Tauman Kalai 的生日是哪天?若知晓,请直接以 DD-MM 格式回答。
在三次独立测试中,模型输出了三个不同(且错误)的答案:"03-07"、"15-06" 和 "01-01"。尽管提问已明确要求模型仅在知晓答案的情况下才作答,但这些答案没有一个是正确的(而他的生日是在秋季)。
这还只是冰山一角。图 1 展示了更复杂,也更令人担忧的幻觉案例。
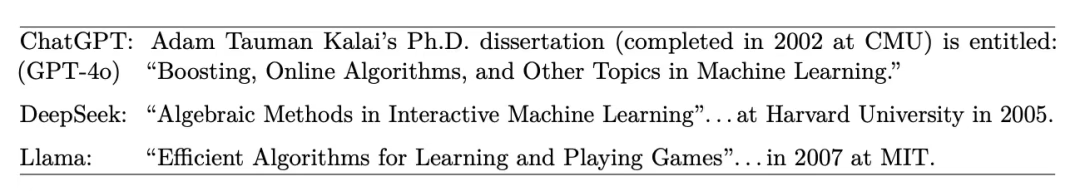
图 1:三个主流语言模型对 "亚当・卡拉伊的博士论文标题是什么?" 这一问题的回答节选,均未生成正确的标题或年份。 [Source][1]
那么,LLM 产生幻觉的真正根源究竟是什么?
OpenAI 的最新研究首次清晰地指出:幻觉之所以发生,是因为模型在不确定时,若选择猜测反而会获得奖励,而坦白说 "我不知道" 却不能。
01 幻觉的种子早在预训练阶段就已埋下
现代语言模型的幻觉并非是凭空产生的。这一问题的根源始于预训练阶段,深植于我们训练模型的方式:让模型基于统计规律 "猜测" 词语,而非基于事实。
让我们深入解析。
1.1 统计上的必然性
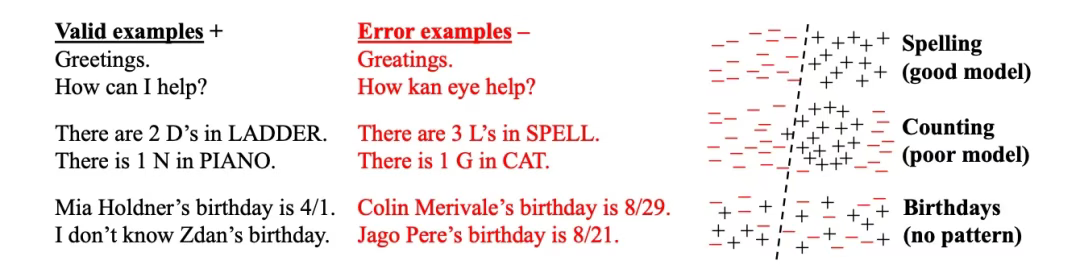
图 2:"Is-It-Valid" 这一方法需要模型通过带有正负标签(+ 表示有效,− 表示无效)的示例(见左图)来学习判断哪些生成内容是合理的。分类器(图中用虚线表示)在某些有明确规则的概念上表现较好,比如拼写(上图);但在以下两种情况下容易出错:模型能力不足(中图)和数据中缺乏规律的事实(下图)[Source][1]
如果将文本生成任务重新定义为二分类问题 ------ "这是有效的内容续写吗?",那么幻觉就变得不可避免了。
即便是最优秀的分类器也会犯错。而模型每次选择下一个 token 时,本质上都在执行这样的二元判断。
换句话说,如果你的分类器会出错,你的生成器也必然出错。道理就这么简单。
1.2 数据的稀缺性
当训练数据中某个事实仅出现一次 ------ 比如某种冷门、小众的知识,模型根本就没有机会准确记住它。
这类仅出现一次的事实,通常被称为 "单例"(singletons),在生成过程中极其容易被扭曲或捏造。
换句话说,模型的最低幻觉率至少等于数据中单例所占的比例。
1.3 模型本身的局限性
有时,无论数据多么干净,模型架构本身就不具备学习某些模式的能力。
如果模型连 "某些三元组(比如字母序列)是否可能出现" 都无法判断,那就别指望它能保持事实一致性了。
换句话说,当一类模型无法表达正确的规则时,幻觉就不仅不可避免,还会频繁发生。
02 后训练不仅未能抑制幻觉,反而强化了它
如果说在预训练阶段悄悄埋下了幻觉的种子,那么后训练阶段往往是在给这些种子浇水 ------ 尤其是当奖励信号与模型的不确定性不匹配时。
事实上,研究人员对 10 个主流大语言模型(LLM)基准测试进行了元评估(见表 2),发现了一个令人震惊的现象:每一个基准测试都在惩罚模型表达不确定性的行为。
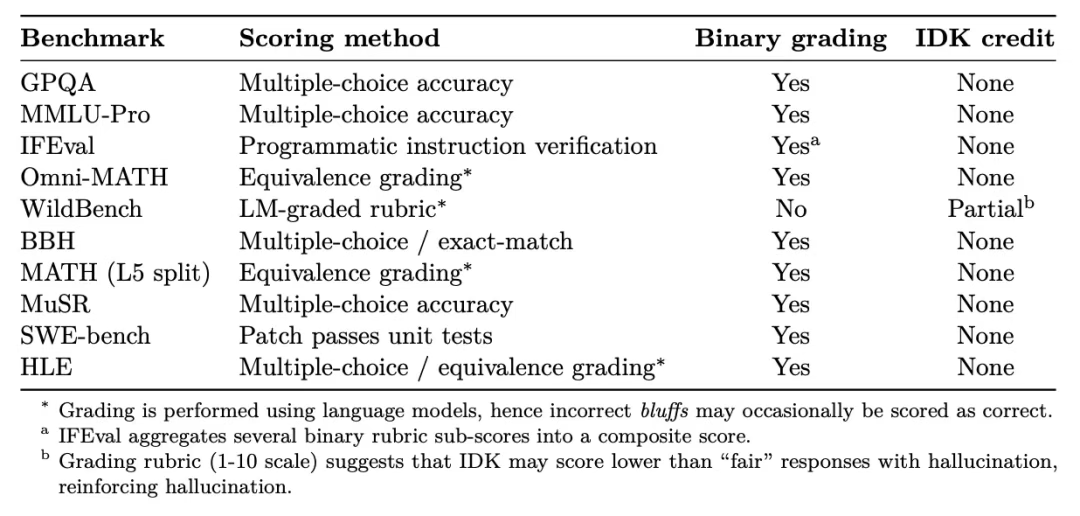
图 3:本研究分析的各项评估基准测试,以及它们如何对待模型的 "弃答" 行为。"Binary grading" 指主要评估指标采用严格的正误判断机制(回答要么完全正确得分,要么错误不得分);"IDK credit" 表示弃答行为是否能获得部分分数。[Source][1]
03 各训练阶段如何助长幻觉
预训练:即使数据 100% 准确,其训练目标(密度估计)仍会迫使模型做出自信的猜测。老师只给你展示标准答案,但期末考试时,你却必须把所有空都填上 ------ 哪怕是那些你从未学过的内容。
后训练(例如 RLHF) :采用二元制评分 ------ 答对得 1 分,答错得 0 分,这实际上就是在惩罚模型 "保持沉默" 的行为。这就像做多项选择题,猜答案总比留空好,因为留空得零分。
04 如何改进
与其再创建一个幻觉评估基准测试,不如做点更聪明的事 ------ 从根本上改变我们评估模型的方式。核心思路是,重塑当前基准测试中内嵌的激励机制,让模型因 "准确" 而获得奖励,而不仅仅因为 "自信"。
具体方法如下:
4.1 基于置信度阈值 t 的评分机制
提出一个简单的计分规则:
答对 → +1 分
答错 → 扣分,扣分为 t / (1 − t)
回答 "我不知道"(IDK)→ 0 分
在此机制下,模型只有在置信度超过阈值 t 时才应作答;否则,"IDK" 才是更优选择。换言之,盲目猜测将变得不划算 ------ 这正是我们希望看到的。
4.2 显式设定阈值
不再将惩罚隐藏在评分逻辑中,而是将置信度阈值 t 明确写入任务指令。这让评估过程更透明、可复现且公平,尤其适用于那些能够接受的 "不确定性" 程度各不相同的任务。
4.3 将该评分机制嵌入现有基准测试
无需从头设计一个 "幻觉基准测试",而是建议将这套评分逻辑直接整合进现有基准测试中 ------ 例如 SWE-bench。
这一改动虽小,却意义深远:当前的二元制评分体系(对 = 1,错 = 0)鼓励模型盲目自信,而新机制则彻底逆转了这一激励方向。
4.4 以行为校准(Behavioral Calibration)作为评估指标
为检验模型是否真正遵守规则,提出 "行为校准" 这一评估方式:
模型是否只在置信度 ≥ t 时作答,否则就回答 "IDK"?
可通过在不同阈值下测量准确率与错误率来评估这一点。
4.5 提供具体、可用的阈值示例
研究甚至给出了阈值的参考值:
t = 0.5 → 对猜测行为的惩罚 = 1
t = 0.75 → 对猜测行为的惩罚 = 3
t = 0.9 → 对猜测行为的惩罚 = 9
现实应用场景风险越高,所需的阈值就应越高。这是一种简单却强大的系统调优方式。
4.6 总结
其核心思想精妙而有力:让 "在不确定时猜测" 成为一种明确的非理性策略。
唯有如此,模型才真正有动机说 "我不知道" ------ 不仅仅是一种新奇的、偶尔为之的表现,而是一种理性的、经过权衡后的选择。
05 思考与启示
多年来,关于 "大语言模型为何会产生幻觉" 的问题一直存在。这项研究为这一问题引入了一个清晰的、基于统计学的视角 ------ 不再将幻觉视为某种神秘的故障,而是将其重新定义为两种力量共同作用下的必然结果:二元分类错误,以及鼓励猜测的评估激励机制。
尤为巧妙的是他们的解决思路:引入一个明确的置信度阈值 t ,并用一个简单公式 ------ t/(1−t) 来对错误答案施加惩罚。 突然之间,"除非确信无疑,否则不要猜测" 在数学意义上就成了最优策略。这是对当前主流 0/1 评分方式的一次干净利落而有力的修正。
我想补充一个建议 ------ 我认为,随着模型越来越接近实际部署,这一点会愈发重要:围绕一个类似 "coverage@target precision t" 这样的指标建立统一标准。换句话说,你的模型能在不跌破某一精度阈值的前提下,正确回答多少问题?
为了让这一方法具备可操作性与透明度,我们应该针对不同 t 值发布帕累托曲线(Pareto curves),从而激励模型比拼 "安全覆盖范围" ------ 而不是比谁更敢瞎猜。
当然,一旦置信度阈值被写进规则,模型可能会开始 "钻空子" ------ 要么虚增自己的置信度以跨过阈值,要么专门针对评分函数进行优化,而非追求真实场景下的实用性。
我们还需警惕评估者的偏见。当前许多基准测试本身就用大语言模型来自动评分,而这些自动评分器常常把错误答案误判为正确。这实际上是在奖励幻觉 ------ 只不过包装得更精致罢了。
为避免这种情况,任何新的评分机制都必须配套以下措施:
独立的校准审计(例如:模型的置信度是否真实反映了现实情况?)
分布偏移压力测试(在基准测试的 "沙盒" 之外,模型的行为是否依然稳健?)
我们的目标不仅是 "在纸面上减少幻觉",更是要确保模型在真实世界中真正更值得信赖 ------ 而不是仅仅在考试中表演得更好。
参考文献: Why Language Models Hallucinate [1].
END
本期互动内容 🍻
❓你觉得 "惩罚瞎猜" 比 "奖励正确" 更重要吗?为什么?
文中链接
[1]https://arxiv.org/pdf/2509.04664v1
原文链接:
https://aiexpjourney.substack.com/p/what-really-causes-hallucinations



- AI 应用落地:原理、架构与工程实践
- 戏说AI:概率、幻觉与智能体
- AI 时代的“HTML 时刻”:一个被严重低估的知识标准 OKF
- 做好这个标记,你的AI引用率可以从0.8%飙升到6.2%
- JSON-LD结构化数据实战指南:GEO优化大师亲授,让AI优先推荐你的内容
- 十年前“AI教父”断言这个岗位将被淘汰,如今年薪超57万美元
- 26名Meta员工指控扎克伯格借助AI精准裁员8000人
- 苹果 Apple 智能在列,网信部门发布 7 款提供手机端侧生成式人工智能服务已备案信息
- 独立开发者用 14 年歌单蒸馏出专属音乐品味的 AI 电台
- 实战视频来了!JeecgBoot 低代码 AI Skills 代码生成器 —— 一句话生成系统